Analyse de données & ML2026
Stage Data Analytics OIBSIP
Neuf analyses de données, du nettoyage à la détection de fraude
Les neuf tâches des niveaux 1 et 2 du parcours Data Analytics d'Oasis Infobyte, chacune livrée avec son notebook, ses données, ses graphiques et un README qui présente la méthode, les résultats et les limites.
En bref
- Le problème
- Un jeu de données réel est rarement propre ni équilibré : valeurs manquantes, doublons, classes rares. Un indicateur mal choisi peut alors annoncer un excellent score pour un modèle inutile.
- L'objectif
- Mener chaque analyse jusqu'à une conclusion exploitable, avec des métriques adaptées au problème et les limites écrites noir sur blanc.
- Ma contribution
- Seul contributeur du dépôt public : notebooks, nettoyage des données, modèles, graphiques et README des neuf tâches.
- Technologies
- Python
- pandas
- scikit-learn
- imbalanced-learn
- NLTK
- VADER
- plotly
- Jupyter
Résultats
- tâches des niveaux 1 et 2 terminées et publiées
- fraudes du jeu de test détectées, avec 6 fausses alertes sur 56 651 transactions légitimes
- de R² pour la prédiction des prix immobiliers par régression linéaire
Les neuf tâches
- Nettoyage des ventes d'un café : 1 951 valeurs manquantes retrouvées exactement grâce à deux règles métier.
- Analyse exploratoire des ventes de centres commerciaux d'Istanbul : vêtements, chaussures et technologie font 95 % du chiffre d'affaires.
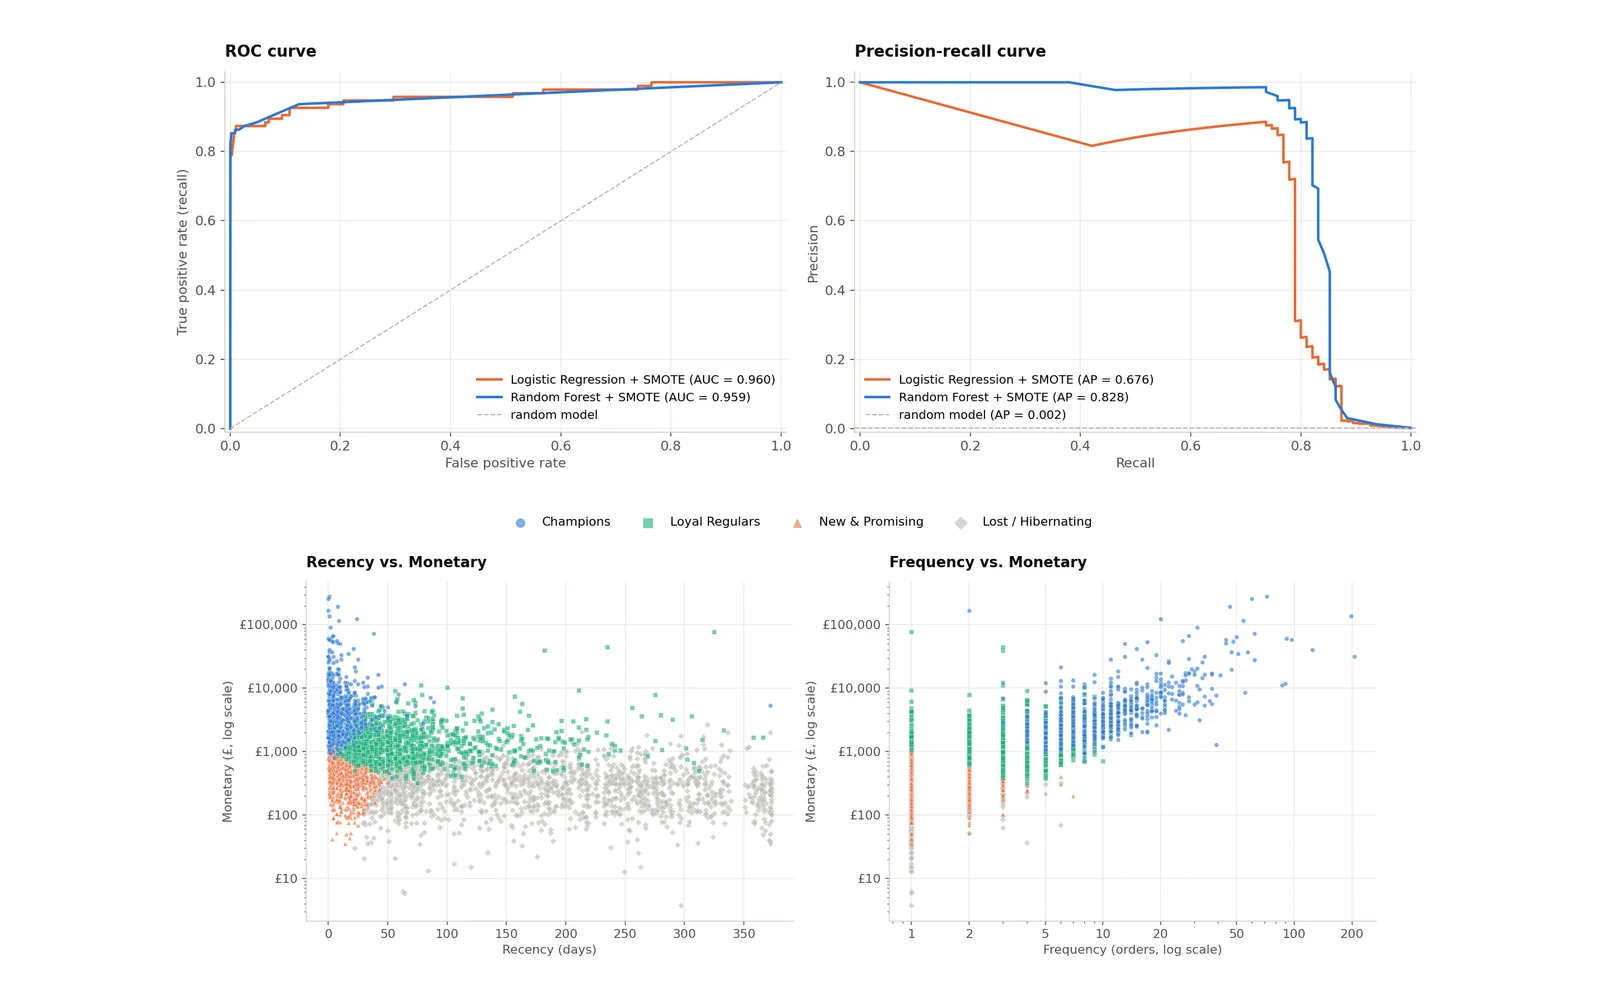
- Segmentation RFM et K-Means : 4 segments, dont les « Champions », 16 % des clients et 64 % du chiffre d'affaires.
- Sentiment des tweets adressés aux compagnies aériennes : régression logistique à 79,3 % d'exactitude, contre 44,7 % pour TextBlob.
- Prix immobiliers par régression linéaire : R² de 0,909 avec 14 variables, effet de chaque variable exprimé en % du prix.
- Qualité des vins : Random Forest à 81,3 % d'exactitude pour repérer les vins notés 7 ou plus.
- Fraude à la carte bancaire (0,17 % de fraudes) : SMOTE et Random Forest, F1 de 0,852 et PR-AUC de 0,828.
- Google Play Store : 92 % d'applications gratuites, 68 % d'avis positifs selon VADER.
- Saisie semi-automatique et correction : trigrammes avec repli, et Damerau-Levenshtein qui corrige 23 fautes courantes sur 25.
Sources des informations de cette page : Dépôt OIBSIP (nouvel onglet), README de la détection de fraude (nouvel onglet), README des prix immobiliers (nouvel onglet).